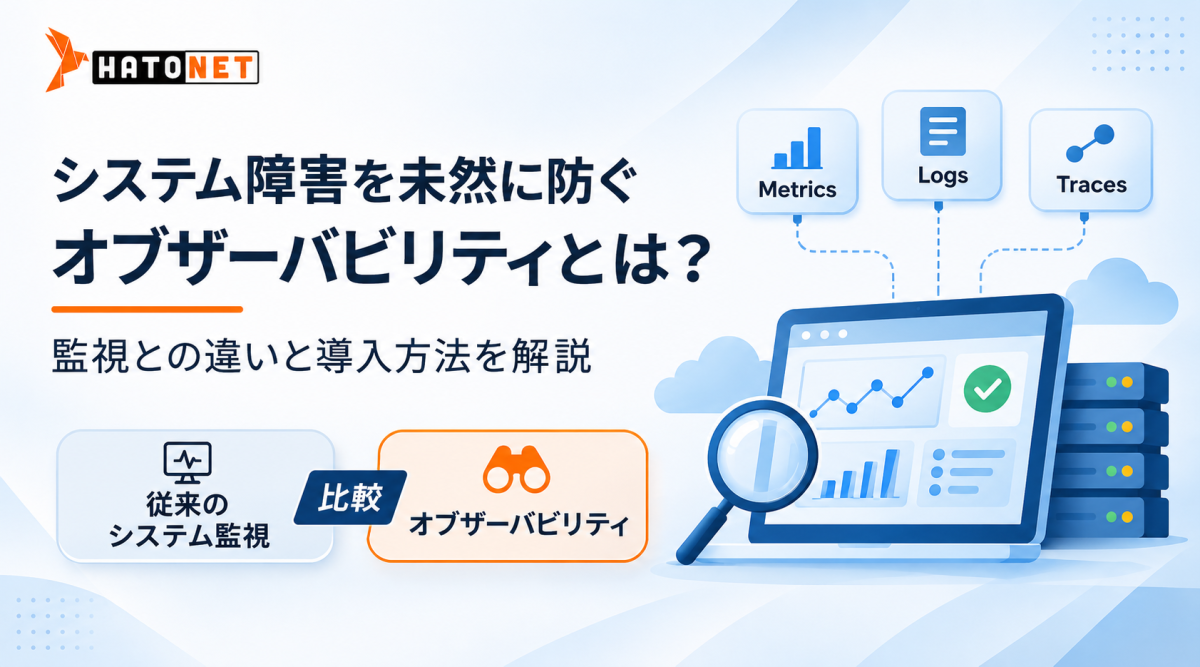
従来のシステム監視では、CPU使用率やメモリ使用量、サーバーの稼働状況などを確認し、あらかじめ設定した条件に基づいてアラートを通知する方法が一般的でした。しかし、システムが複雑になるほど、「異常が発生していることは分かるが、原因がどこにあるのか分からない」という問題が発生しやすくなります。
そこで注目されているのが、オブザーバビリティ(Observability)です。
オブザーバビリティを導入することで、システム内部の状態をさまざまなデータから把握し、障害の予兆や異常の原因を迅速に特定できるようになります。
本記事では、オブザーバビリティの基本的な仕組みから従来の監視との違い、導入するメリット、具体的な導入手順までを分かりやすく解説します。
1. オブザーバビリティとは?
オブザーバビリティとは、日本語で「可観測性」と訳され、システムが外部に出力するデータを分析することで、内部で何が起きているのかを理解できる能力を指します。
簡単に言えば、システムの内部を直接確認できない状況でも、ログやメトリクス、トレースなどの情報を組み合わせて、システムの状態や問題の原因を把握するための考え方です。
例えば、ECサイトで商品購入時の処理が突然遅くなったとします。
従来の監視では、サーバーのCPU使用率やメモリ使用量を確認し、異常がないかを調べることが中心でした。しかし、サーバーのリソースに問題がなくても、データベースへのアクセス遅延や外部決済APIの応答遅延が原因である可能性があります。
オブザーバビリティでは、ユーザーのリクエストがどの処理を通過し、どの部分で時間がかかっているのかを横断的に分析できます。
その結果、単に「処理が遅い」という事実だけでなく、「どのサービスの、どの処理が、なぜ遅くなっているのか」という原因まで調査しやすくなります。
重要なのは、オブザーバビリティが単なる監視ツールではないという点です。システムから収集したデータを相互に関連付け、未知の問題についても調査・分析できる運用環境を構築することが目的です。
2. オブザーバビリティと従来のシステム監視との違い
オブザーバビリティとシステム監視は、似ているようで役割が異なります。
従来の監視は、あらかじめ定義した監視項目やしきい値に基づいて、システムの異常を検知することが主な目的です。
一方、オブザーバビリティは、収集したデータを組み合わせて、異常が発生した原因やシステム内部の動作を詳しく調査することに重点を置いています。
従来の監視とオブザーバビリティの比較
| 比較項目 | 従来のシステム監視 | オブザーバビリティ |
|---|---|---|
| 主な目的 | 異常の検知 | 異常の原因分析・理解 |
| 対象 | サーバーや個別システム | システム全体・サービス間の連携 |
| データ | CPU、メモリ、稼働率など | Metrics、Logs、Tracesなど |
| 分析方法 | しきい値やルールに基づく | 複数データの相関分析 |
| 対応できる問題 | 想定済みの異常 | 想定していなかった問題も調査可能 |
| 主な成果 | 異常の早期検知 | 原因特定と復旧の迅速化 |
例えば、あるWebサービスでレスポンス時間が通常より長くなった場合を考えてみましょう。
従来の監視では、レスポンス時間が設定した基準値を超えたことを検知し、担当者にアラートを送信します。
しかし、それだけでは原因が分かりません。
オブザーバビリティでは、レスポンス時間の変化に加えて、アプリケーションログ、データベースの処理時間、API間の通信状況などを関連付けて調査できます。
これにより、問題が発生している箇所を絞り込み、適切な対応につなげられます。
つまり、監視が「何が起きているか」を知らせる仕組みであるのに対し、オブザーバビリティは「なぜ起きているか」を理解するための仕組みです。
なお、オブザーバビリティは従来の監視を置き換えるものではありません。監視を基盤として、分析・調査能力を高める考え方です。
3. オブザーバビリティを支える3つの主要データ
オブザーバビリティを実現するためには、主に3種類のテレメトリデータを活用します。
それぞれ異なる情報を提供するため、組み合わせて分析することが重要です。
3-1. Metrics(メトリクス)
Metricsとは、システムの状態やパフォーマンスを数値で表したデータです。
一定の時間間隔で数値を収集することで、システムの状態や変化を継続的に把握できます。
主な監視項目は以下のとおりです。
-
CPU使用率
-
メモリ使用量
-
ディスク使用率
-
ネットワーク通信量
-
APIのレスポンス時間
-
リクエスト数
-
エラー発生率
例えば、Webサイトのアクセス数が急増した際に、CPU使用率やレスポンス時間がどのように変化しているかを確認できます。
Metricsは、異常の兆候を早期に発見するための重要なデータです。
3-2. Logs(ログ)
Logsとは、アプリケーションやインフラで発生したイベントや処理内容を記録したデータです。
システム内部で何が起きたのかを、より詳細に把握するために使用します。
例えば、以下のような情報が含まれます。
-
エラー発生時刻
-
APIリクエストの内容
-
データベースへのアクセス結果
-
ユーザー操作の履歴
-
認証エラーや通信エラー
-
アプリケーションの処理結果
例えば、特定のAPIでエラーが増加した場合、ログを確認することで、認証エラーなのか、データベース接続エラーなのかを調査できます。
ログを構造化して保存し、検索・分析しやすい環境を整えることも重要です。
3-3. Traces(トレース)
Tracesとは、1つのリクエストが複数のサービスやシステムを通過して処理される過程を追跡するデータです。
特に、マイクロサービスや分散システムでは重要な役割を果たします。
例えば、ECサイトで商品を購入する場合、次のような処理が実行されます。
-
ユーザーが注文ボタンをクリックする
-
注文管理サービスがリクエストを受け取る
-
在庫管理サービスが在庫情報を確認する
-
決済サービスが決済処理を実行する
-
データベースに注文情報を保存する
-
ユーザーに購入完了画面を表示する
この処理のどこで時間がかかっているのかを可視化できるのがTracesです。
例えば、注文処理全体に5秒かかっている場合、各サービスの処理時間を比較することで、決済APIに4秒かかっていることを特定できる可能性があります。
このように、Tracesは複雑なシステムにおけるボトルネックや障害原因の特定に役立ちます。
4. オブザーバビリティを導入するメリット
企業がオブザーバビリティを導入することで、システム運用の効率化だけでなく、ビジネス面でもさまざまな効果が期待できます。
4-1. システム障害の早期発見
オブザーバビリティでは、システム全体のパフォーマンスやエラーの変化を継続的に把握できます。
例えば、通常よりAPIの応答時間が長くなっている、データベース接続の失敗が増えている、といった異常の兆候を早期に検知できます。
重大な障害が発生する前に原因を調査し、必要な対策を実施できれば、サービス停止のリスクを低減できます。
ただし、オブザーバビリティを導入するだけで障害を完全に防止できるわけではありません。検知後の対応体制や復旧手順と組み合わせることが重要です。
4-2. 障害原因の特定時間を短縮
複雑なシステムでは、障害が発生した際に複数のチームがそれぞれの担当領域を調査するケースがあります。
その結果、原因の切り分けに多くの時間がかかることも少なくありません。
Metrics、Logs、Tracesを関連付けて分析できる環境があれば、問題が発生したサービスや処理を迅速に絞り込めます。
障害の検知から原因特定、復旧までの時間を短縮し、システム運用の負担軽減につなげられます。
4-3. ユーザー体験の改善
サーバーが正常に稼働していても、ユーザーが快適にサービスを利用できているとは限りません。
例えば、トップページは正常に表示されても、検索機能や決済機能だけが遅くなっている可能性があります。
オブザーバビリティでは、個別の機能やAPIのパフォーマンスを分析できるため、ユーザーに影響する問題を発見しやすくなります。
結果として、サービスの品質や顧客満足度の向上が期待できます。
4-4. クラウドインフラのコスト最適化
クラウド環境では、アクセス量や処理負荷に応じてインフラリソースを調整する必要があります。
オブザーバビリティを活用すれば、CPUやメモリの利用傾向、処理量、レスポンス時間などを継続的に分析できます。
必要以上に大きなリソースを確保している箇所や、負荷が集中している箇所を把握し、適切なリソース設計につなげられます。
これにより、安定性を維持しながらクラウド利用コストの最適化を目指せます。
5. オブザーバビリティを導入する5つのステップ
オブザーバビリティの導入では、最初からすべてのシステムに対応しようとする必要はありません。
まずは重要なシステムや業務機能を対象に、小規模な導入から始めることが効果的です。
STEP 1:現状のシステム環境を把握する
最初に、監視対象となるシステムやインフラの構成を整理します。
確認すべき項目は以下のとおりです。
-
サーバーやクラウド環境の構成
-
アプリケーションとデータベースの関係
-
APIや外部サービスとの連携状況
-
現在利用している監視ツール
-
既存のログ収集・管理方法
-
過去に発生した障害と運用上の課題
この段階では、システム全体の構造とデータの流れを可視化することが重要です。
STEP 2:導入目的と監視指標を定義する
次に、オブザーバビリティによって解決したい課題を明確にします。
例えば、以下のような目標が考えられます。
-
APIのレスポンス時間を改善する
-
障害発生時の原因特定時間を短縮する
-
データベースの処理遅延を検知する
-
サービスの可用性を向上させる
-
クラウドインフラの利用コストを最適化する
目的に合わせて、必要なMetrics、Logs、Tracesを定義します。
また、SLI(Service Level Indicator:サービス品質を測定する指標)やSLO(Service Level Objective:サービス品質の目標)を設定することで、運用上の判断基準を明確にできます。
STEP 3:データ収集の仕組みを構築する
オブザーバビリティの基盤となるテレメトリデータの収集環境を構築します。
ここで活用できる技術の一つがOpenTelemetryです。
OpenTelemetryは、Metrics、Logs、Tracesなどのテレメトリデータを計測・収集・処理・エクスポートするためのベンダー中立なオープンソースフレームワークです。
特定の監視ベンダーに依存しにくいデータ収集環境を構築できるため、複数のクラウドサービスやアプリケーションが存在する環境でも活用できます。
アプリケーションへの計測設定やOpenTelemetry Collectorなどを利用し、必要なデータを適切な保存・分析基盤へ送信します。
STEP 4:ダッシュボードとアラートを設定する
収集したデータを担当者が把握しやすいように、ダッシュボードを構築します。
例えば、以下の情報を一元的に確認できるようにします。
-
システム全体の稼働状況
-
APIごとのレスポンス時間
-
エラー発生率
-
サーバーのCPU・メモリ使用率
-
データベースの処理状況
-
サービスごとの依存関係
さらに、重要な指標に対してアラートを設定します。
ただし、アラートを過剰に設定すると、担当者が大量の通知に追われ、本当に重要な障害を見落とす可能性があります。
そのため、ビジネスへの影響度や対応の緊急性に応じて通知ルールを設計することが大切です。
STEP 5:運用・分析・継続的な改善を行う
導入後は、収集したデータを定期的に分析し、システムの改善につなげます。
障害が発生した際には、収集したデータを使って原因を調査し、対応内容や再発防止策を記録します。
また、サービスの変更や新機能の追加に合わせて、監視項目やダッシュボードも更新する必要があります。
オブザーバビリティは、一度構築すれば完了する仕組みではありません。
継続的にデータの品質や監視範囲を見直し、運用プロセスを改善することが重要です。
6. オブザーバビリティ導入で活用できる主なツール
オブザーバビリティを実現するためのツールには、オープンソースからクラウド事業者が提供するマネージドサービスまで、さまざまな選択肢があります。
代表的なものを紹介します。

特に、Google Cloud環境では、以下のサービスを組み合わせることで、オブザーバビリティ基盤を構築できます。
-
Cloud Monitoring: インフラやアプリケーションのメトリクス収集・可視化・アラート設定
-
Cloud Logging: ログの保存・検索・分析
-
Cloud Trace: リクエストの処理経路やレイテンシの分析
-
Error Reporting: アプリケーションで発生したエラーの集約・把握
ただし、最適なツールはシステムの構成や規模、既存のクラウド環境、運用体制によって異なります。
単に機能の多いツールを選ぶのではなく、導入目的や必要なデータ、運用コストを踏まえて選定することが大切です。
7. オブザーバビリティ導入で注意すべき4つのポイント
オブザーバビリティは多くのメリットがある一方、設計や運用方法を誤ると、導入コストや運用負荷が増加する可能性があります。
7-1. 必要以上のデータを収集しない
大量のログやトレースデータを無計画に収集すると、保存容量やデータ転送量が増加し、コストが高くなる可能性があります。
ビジネス上重要なシステムや処理を優先し、必要なデータを選定することが重要です。
7-2. アラートの優先順位を明確にする
すべての異常を同じ重要度で通知すると、担当者の負担が増加します。
サービス停止や顧客への影響が大きい問題を優先し、緊急度に応じた通知ルールを設計しましょう。
7-3. セキュリティと個人情報を適切に管理する
ログやトレースには、ユーザーID、リクエスト情報、取引情報などの機密情報が含まれる場合があります。
そのため、収集対象の制御、アクセス権限の管理、データのマスキング、保存期間の設定など、適切なセキュリティ対策が必要です。
7-4. 運用担当者と対応フローを整備する
異常を検知できても、誰が対応するのか、どのように原因を調査するのかが決まっていなければ、迅速な復旧は困難です。
担当者の役割、エスカレーションルール、障害対応手順などを整備し、ツールと組織の両面から運用体制を構築しましょう。
8. まとめ:オブザーバビリティで実現する安定したシステム運用
企業のシステムが複雑化する中で、従来の監視だけでは障害の根本原因を特定することが難しくなっています。
オブザーバビリティは、Metrics、Logs、Tracesなどのデータを組み合わせることで、システム内部の状態を可視化し、異常の検知から原因分析までを支援する考え方です。
導入を成功させるためには、以下のポイントが重要です。
-
現状のシステム構成と運用課題を把握する
-
ビジネスに影響する指標を明確にする
-
Metrics、Logs、Tracesを適切に収集する
-
OpenTelemetryなどを活用してデータ連携を整備する
-
アラートや障害対応フローを最適化する
-
導入後も継続的に分析・改善する
オブザーバビリティは、単なる障害監視の高度化ではなく、システムの信頼性と運用品質を継続的に高めるための重要な取り組みです。
クラウド移行やマイクロサービス化、レガシーシステムの刷新を進める企業にとって、設計段階からオブザーバビリティを考慮することが、将来的な運用負荷や障害リスクの低減につながります。
Hatonetでは、Google Cloudの導入・構築から運用・監視まで、企業のシステム環境に合わせた支援を提供しています。
Cloud MonitoringやCloud Loggingの設定、障害対応、インフラの最適化など、安定したシステム運用に関する課題をお持ちの場合は、ぜひご相談ください。
Hatonetは、エンジニアや戦略コンサルなどの専門家が集結する、AI駆動と組織AXへの変革を牽引する伴走型ソリューションカンパニーです。
新規事業の立ち上げから大手企業のDX支援まで、開発の上流から下流まで一貫したサービスを提供しています。
パートナーを見つけるコストを節約します。
さらに、日本常駐エンジニア・AI専門家・Google Cloudの強みを掛け合わせ、スピード・精度・低リスクを兼ね備えたシステム刷新を実現する、新たな時代のIT戦略・開発パートナーです。
メール: nagata@hatonet.jp
- レガシーモダナイゼーション 25
- AIモダナイゼーション 38
- ベトナムの文化 13
- IT人材市場 280
- お知らせ 13
- 会員紹介 13

顧客サポート
以下のQRコードをスキャンして、Lineですぐにお問い合わせください。