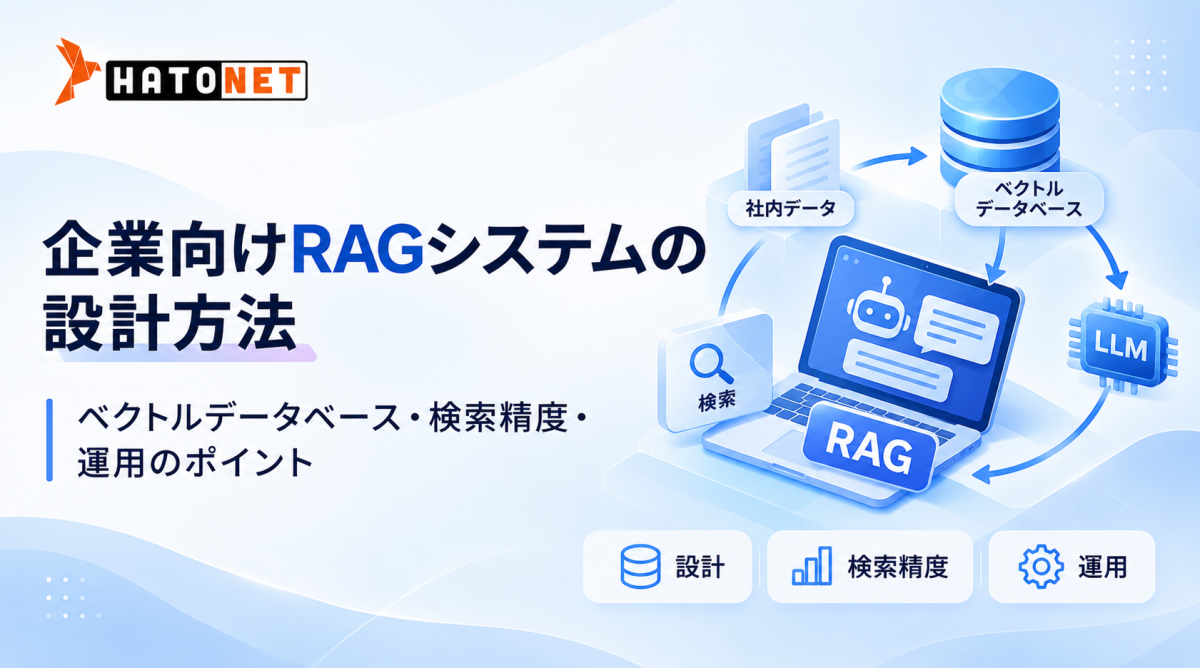
RAGは、社内文書や業務マニュアル、顧客情報、過去のプロジェクト資料などを検索し、その情報をもとに大規模言語モデル(LLM)が回答を生成する仕組みです。
一般的な生成AIでは、学習データに含まれていない社内独自の情報や最新の業務データについて、正確に回答することが困難です。一方、RAGを導入すれば、企業が保有するデータを参照しながら、より業務に即した回答を生成できます。
しかし、RAGシステムは単にLLMとベクトルデータベースを接続すれば完成するものではありません。データの前処理、検索方式、アクセス制御、回答精度の評価、継続的な運用まで考慮する必要があります。
本記事では、企業向けRAGシステムの基本構成から、ベクトルデータベースの選定、検索精度を高める方法、実運用で押さえるべきポイントまでを解説します。
1. 企業向けRAGシステムとは?
RAGとは、外部の知識データを検索し、その検索結果をLLMに提供することで回答を生成する技術です。
企業向けRAGシステムでは、社内に分散している情報をナレッジベースとして統合し、社員が自然言語で必要な情報を検索できる環境を構築します。
例えば、次のような業務に活用できます。
-
社内規定や就業規則に関する問い合わせ対応
-
過去の提案書やプロジェクト資料の検索
-
製品仕様書や技術マニュアルの参照
-
カスタマーサポートにおけるFAQ回答
-
営業担当者向けの顧客情報・商談履歴の検索
-
システム開発における設計書やソースコード関連情報の参照
RAGの基本的な処理フロー
企業向けRAGシステムは、大きく分けてデータ登録と質問応答の2つの処理で構成されます。
① データ登録(Indexing)
-
PDF、Word、Excel、Webページ、データベースなどから情報を取得する
-
不要な情報や重複データを整理する
-
文書を適切なサイズに分割する(Chunking)
-
Embeddingモデルでテキストをベクトル化する
-
ベクトルデータベースに保存する
② 質問応答(Retrieval & Generation)
-
ユーザーが自然言語で質問する
-
質問文をベクトル化する
-
ベクトルデータベースから関連情報を検索する
-
必要に応じて検索結果を再ランキングする
-
関連情報をLLMに渡す
-
検索結果に基づいて回答を生成する
この仕組みにより、LLMが事前学習していない企業固有の情報も活用できるようになります。
2. ベクトルデータベースの選定方法
RAGシステムの検索精度や処理性能を左右する重要な要素が、ベクトルデータベースです。
ベクトルデータベースは、Embeddingモデルによって数値化されたデータを保存し、意味的な類似性に基づいて関連情報を検索するための仕組みです。
企業向けシステムでは、データ量、検索速度、拡張性、セキュリティ、既存システムとの連携を考慮して選定する必要があります。
主なベクトルデータベースの比較

※上記は代表的な選択肢です。実際の性能や運用コストは、データ量、インフラ構成、検索条件によって異なります。
選定時に確認すべき5つのポイント
1. データ量と拡張性
将来的に数万件から数百万件以上の文書を扱う可能性がある場合、データ量の増加に対応できる構成を検討します。
2. 検索性能
同時アクセス数や応答時間の要件を明確にし、実際のデータを使用して検索速度を検証します。
3. メタデータフィルタリング
部署、文書種別、更新日、プロジェクトIDなどの条件で検索対象を絞り込めることが重要です。
4. セキュリティとアクセス制御
企業では、社員全員がすべての情報にアクセスできるわけではありません。ユーザーの権限に応じた検索制御が必要です。
5. 運用コスト
ストレージ費用、検索処理、Embedding生成、インフラ管理などを含めた総コストで比較します。
必ずしも高機能な専用データベースが最適とは限りません。既存のデータベース環境を活用することで、開発・運用コストを抑えられるケースもあります。
3. RAGの検索精度を高めるための設計ポイント
RAGシステムの品質を決める大きな要因は、LLMそのものの性能だけではありません。必要な情報を正しく取得できるかどうかが、最終的な回答品質に大きく影響します。
3-1. 適切なチャンク分割(Chunking)
チャンク分割とは、長い文書を検索しやすい単位に分割する処理です。
例えば、100ページの技術マニュアルをそのまま登録すると、質問に関係のない情報まで検索対象に含まれる可能性があります。
一方、細かく分割しすぎると、文章の前後関係や説明の意味が失われることがあります。
そのため、以下の点を考慮して設計します。
-
文書の見出しや章構成に沿って分割する
-
関連する文章の前後関係を保持する
-
適切なチャンクサイズを検証する
-
必要に応じてチャンク間にオーバーラップを設定する
-
表や箇条書きなどの構造情報を維持する
すべての文書に同じ分割ルールを適用するのではなく、PDF、FAQ、技術仕様書など、データの種類に応じて最適化することが重要です。
3-2. Embeddingモデルの最適化
Embeddingモデルは、文章の意味を数値ベクトルに変換するモデルです。
日本企業向けのRAGでは、日本語の検索精度が重要になります。
特に、次のような情報を扱う場合は慎重なモデル選定が必要です。
-
日本語特有の表現や専門用語
-
IT・製造・金融などの業界用語
-
日本語と英語が混在する技術文書
-
製品名やシステム名などの固有名詞
Embeddingモデルによって検索結果は変わるため、実際の業務データと質問例を使用して比較検証することが推奨されます。
3-3. ハイブリッド検索の導入
ベクトル検索は文章の意味的な類似性を捉えることに優れていますが、製品コード、社員番号、エラーコード、固有名詞などの完全一致が求められる検索では、必ずしも最適とは限りません。
そこで有効なのが、ベクトル検索とキーワード検索を組み合わせる「ハイブリッド検索」です。

例えば、「過去に発生した認証エラーの対応方法」という質問では、意味的に関連する資料をベクトル検索で取得しながら、特定のエラーコードをキーワード検索で補完できます。
さらに、検索結果を統合した後に再ランキング(Reranking)を実施すると、質問との関連性が高い情報を優先できます。
ただし、Rerankingを追加すると処理時間やコストが増加するため、精度向上とのバランスを確認する必要があります。
4. 企業向けRAGシステムで重要なセキュリティ対策
社内情報を生成AIに連携する場合、情報漏えいや不正アクセスへの対策は不可欠です。
特に、企業向けRAGでは検索対象のデータそのものだけでなく、誰がどの情報を取得できるかを管理する必要があります。
主なセキュリティ対策
① アクセス権限管理
ユーザーや部署、役職、プロジェクト単位でアクセス権限を設定します。検索時にも権限情報を適用し、閲覧権限のない文書がLLMに渡らないようにします。
② データの暗号化
保存データと通信データの暗号化を実施し、認証情報やAPIキーを適切に管理します。
③ 機密情報の取り扱い
個人情報、顧客情報、契約情報などを分類し、必要に応じてマスキングやアクセス制限を行います。
④ プロンプトインジェクション対策
検索対象の文書に悪意のある指示が含まれている可能性も考慮し、取得した文書を信頼できない入力として扱う設計が必要です。
⑤ ログと監査
ユーザーの検索履歴、参照した文書、生成された回答などを記録し、不正利用や情報漏えいの調査に活用できるようにします。
また、検索結果をLLMに渡す前のアクセス制御だけでなく、回答生成後の情報漏えいチェックも重要です。
RAGは社内データを活用するための技術ですが、導入しただけで情報管理の安全性が保証されるわけではありません。
5. RAGシステムの導入後に必要な運用・改善
RAGシステムは、一度構築すれば完成するものではありません。社内文書の更新や業務ルールの変更に合わせて、継続的にメンテナンスする必要があります。
5-1. データの定期更新
古い情報が検索されると、誤った回答につながる可能性があります。
そのため、以下のような運用ルールを設定します。
-
新しい文書の定期的な取り込み
-
更新・削除された文書のインデックス反映
-
重複データの整理
-
古い情報の無効化
-
データ同期エラーの監視
5-2. 検索精度と回答品質の評価
RAGの品質を改善するには、検索精度と生成された回答の両方を評価する必要があります。
代表的な評価指標は以下の通りです。

実際の業務で想定される質問をテストデータとして用意し、検索方式やEmbeddingモデル、チャンクサイズを変更した際に結果を比較します。
また、回答できない質問に対して、無理に回答を生成せず「該当する情報が見つかりませんでした」と返せる仕組みも重要です。
5-3. 運用状況のモニタリング
本番環境では、精度だけでなく、応答速度やコストも継続的に確認します。
特に注目したいKPIは次の通りです。
-
平均回答時間
-
検索成功率
-
回答の正確性
-
ユーザーによる回答評価
-
1回あたりのAPI利用コスト
-
エラー発生率
-
利用ユーザー数
これらの指標を定期的に分析し、検索ロジックやデータ構造、プロンプトを改善することが、長期的な運用成功につながります。
6. 企業向けRAGシステム導入の進め方
初めから全社規模のRAGシステムを構築するのではなく、小さな業務領域から段階的に導入する方法が効果的です。

PoCでは、単にAIが回答できるかどうかを確認するだけでなく、実際の業務でどの程度の時間削減や業務効率化が期待できるかを検証することが重要です。
例えば、社内問い合わせ対応を対象とする場合、従来の情報検索にかかっていた時間とRAG導入後の時間を比較することで、導入効果を定量的に評価できます。
7. まとめ|RAGの成功にはシステム全体の設計が重要
企業向けRAGシステムを成功させるためには、LLMの選定だけでなく、データの前処理、ベクトルデータベース、検索ロジック、アクセス制御、運用体制までを一貫して設計する必要があります。
特に重要なポイントは以下の5つです。
-
業務要件とデータ特性に適したベクトルデータベースを選定する
-
文書の種類に応じて適切なチャンク分割とEmbeddingを設計する
-
ハイブリッド検索やRerankingによって検索精度を高める
-
権限管理・暗号化・監査ログなどのセキュリティを確保する
-
評価指標とモニタリングを通じて継続的に改善する
RAGは、社内ナレッジの活用、問い合わせ対応の効率化、営業支援、技術情報の検索など、さまざまな企業業務に応用できる技術です。
重要なのは、最新のAI技術を導入すること自体ではなく、自社の業務課題を解決できるシステムを設計することです。
HatonetのAI開発・導入支援
Hatonetでは、企業のAI活用やシステム刷新を支援するため、AIモダナイゼーション、FDE伴走・AIエージェント開発支援、Google Cloud導入・構築などのサービスを提供しています。
RAGシステムの構想策定から、技術選定、アーキテクチャ設計、開発、既存システムとの連携、運用改善まで、企業の課題や開発体制に応じた支援が可能です。
「社内ナレッジをAIで活用したい」「既存システムと生成AIを連携させたい」「RAGのPoCから本番導入まで進めたい」とお考えの企業様は、ぜひHatonetにご相談ください。
AIを活用した業務変革を、構想から実装・運用まで支援します。
Hatonetは、エンジニアや戦略コンサルなどの専門家が集結する、AI駆動と組織AXへの変革を牽引する伴走型ソリューションカンパニーです。
新規事業の立ち上げから大手企業のDX支援まで、開発の上流から下流まで一貫したサービスを提供しています。
パートナーを見つけるコストを節約します。
さらに、日本常駐エンジニア・AI専門家・Google Cloudの強みを掛け合わせ、スピード・精度・低リスクを兼ね備えたシステム刷新を実現する、新たな時代のIT戦略・開発パートナーです。
メール: nagata@hatonet.jp
- レガシーモダナイゼーション 25
- AIモダナイゼーション 38
- ベトナムの文化 13
- IT人材市場 280
- お知らせ 13
- 会員紹介 13

顧客サポート
以下のQRコードをスキャンして、Lineですぐにお問い合わせください。